Hoe het MIXIT-team bij AkzoNobel deploymentsnelheid en betrouwbaarheid combineert met een gelaagd resilience-model.
Inleiding
Hoe combineer je een hoge deploymentsnelheid met een stabiele productieomgeving? Elke keer dat je vaker deployt, neemt ook het risico op een defecte versie in productie toe. Geautomatiseerde tests vangen afgebakende fouten goed op, maar beschermen je niet tegen onverwachte problemen in de keten: een upstream API die ineens anders reageert, een database die trager wordt onder piekbelasting, of een externe dienst die stilletjes begint te throttlen.
Dit soort problemen zijn met traditionele monitoring lastig te detecteren. Vaak zie je het pas als je Service Level Objectives (SLO’s) er al onderdoor gaan. Om je SLA’s te kunnen halen zonder de snelheid van Trunk-Based Development af te remmen, heb je een resilience-architectuur nodig die automatisch reageert, escaleert en herstelt.
In mijn vorige blogs legde ik de basis voor een betrouwbare software lifecycle: hoe je met SLA’s, SLI’s en SLO’s de daadwerkelijke klantervaring meetbaar maakt, en hoe Trunk-Based Development de deploymentsnelheid verhoogt door meerdere keren per dag kleine changesets naar productie te brengen.
In dit artikel laat ik zien hoe we met het MIXIT-team bij AkzoNobel een eigen mechanisme hiervoor hebben gebouwd. Onze architectuur bestaat uit drie schillen: lokaal, regionaal en globaal. Samen vormen ze een gelaagd model waarmee we deploymentsnelheid en betrouwbaarheid kunnen combineren.
De drie schillen: een gelaagd model
Resilience is geen enkel mechanisme, maar een gelaagd model. Elke laag vangt een ander type falen op.
| Schil | Scope | Mechanisme | Reactietijd | SLA-impact |
|---|---|---|---|---|
| Lokaal | Per service-instantie | Circuit Breaker (AN.MIXIT) | Milliseconden | Voorkomt cascade-failures |
| Regionaal | Per Azure-regio | Durable Entities + Table Storage | Seconden | Coördineert collectief herstel |
| Globaal | Cross-regio | Traffic Manager + DNS Failover | 60–330 sec (DNS TTL) | Geo-redundante uptime |
De onderstaande figuur laat zien hoe de drie schillen samenwerken.

Globaal: De Traffic Manager monitort de health van elke regio en routeert gebruikers naar gezonde endpoints via DNS.
Regionaal: De coördinatielaag ontvangt foutmeldingen van applicatie-instanties en signaleert wanneer circuits moeten worden geopend.
Lokaal: De downstream dependencies retourneren foutmeldingen en latenties die door de applicatie worden geregistreerd bij de coördinatielaag.
Waarde van geautomatiseerde bescherming en resource-besparing
Wanneer een downstream service faalt en er geen circuit breaker actief is, blijven requests wachten op een timeout. Threads, database-connections en geheugen blijven ondertussen bezet. Bij 50 requests per seconde en een timeout van 30 seconden resulteert dit in 1.500 gelijktijdig geblokkeerde threads, totdat er handmatige interventie plaatsvindt.
Met AN.MIXIT.CircuitBreaker detecteert de failure-teller de falende service automatisch. Het monitor-endpoint retourneert vervolgens 503, waarna Traffic Manager binnen seconden stopt met het routeren van verkeer naar de regio. Nieuwe requests bereiken de falende downstream service niet meer:
- Zonder oplossing: 50 req/s × 30s timeout = 1.500 gelijktijdig geblokkeerde threads (tot handmatige interventie)
- Met oplossing: Verkeer stopt via Traffic Manager failover binnen ~90 seconden na de eerste fout
- Besparing: Geen verdere thread-blokkering of connection pool-uitputting na automatische failover
SLA-analyse: de betrouwbaarheid van de keten
Om te bepalen of de architectuur voldoet aan de eisen, analyseren we de officiële Microsoft Azure SLA’s. We toetsen hierbij specifiek of we de kritieke ondergrens van 98% beschikbaarheid halen.
1. Individuele componenten (Single Region)
Voor een opzet binnen één Azure-regio zijn we afhankelijk van componenten zoals routering en persistente opslag met beschikbaarheden tussen de 99,9% en 99,99%. De gecombineerde SLA voor een enkele regio wordt berekend door deze waarden te vermenigvuldigen (bijvoorbeeld 99,95% × 99,9% × 99,99%), wat in de praktijk neerkomt op zo’n 99,84%. Zelfs in deze opzet in één regio wordt de grens van 98% dus overschreden.
2. Multi-Regio Active-Active scenario (twee of drie regio’s)
In een geografisch redundante opzet wordt de beschikbaarheid bepaald door de kans dat alle actieve regio’s gelijktijdig falen.
Bij een opzet met drie regio’s wordt de totale beschikbaarheid effectief begrensd door de SLA van de load balancer (zoals Azure Traffic Manager). Dit vormt daarmee de theoretische maximale limiet van de SLA.
| Scenario | Theoretische SLA | Downtime per jaar | Status vs. 98% doel |
|---|---|---|---|
| Single Region | 99,84% | ~14 uur | Ruim voldoende |
| Multi-Region (2 regio’s) | 99,989% | ~58 minuten | Excellent |
| Multi-Region (3 regio’s) | 99,99% | ~52 minuten | Maximaal haalbaar |
Van techniek naar beschikbaarheid
Impact op uptime en MTTR
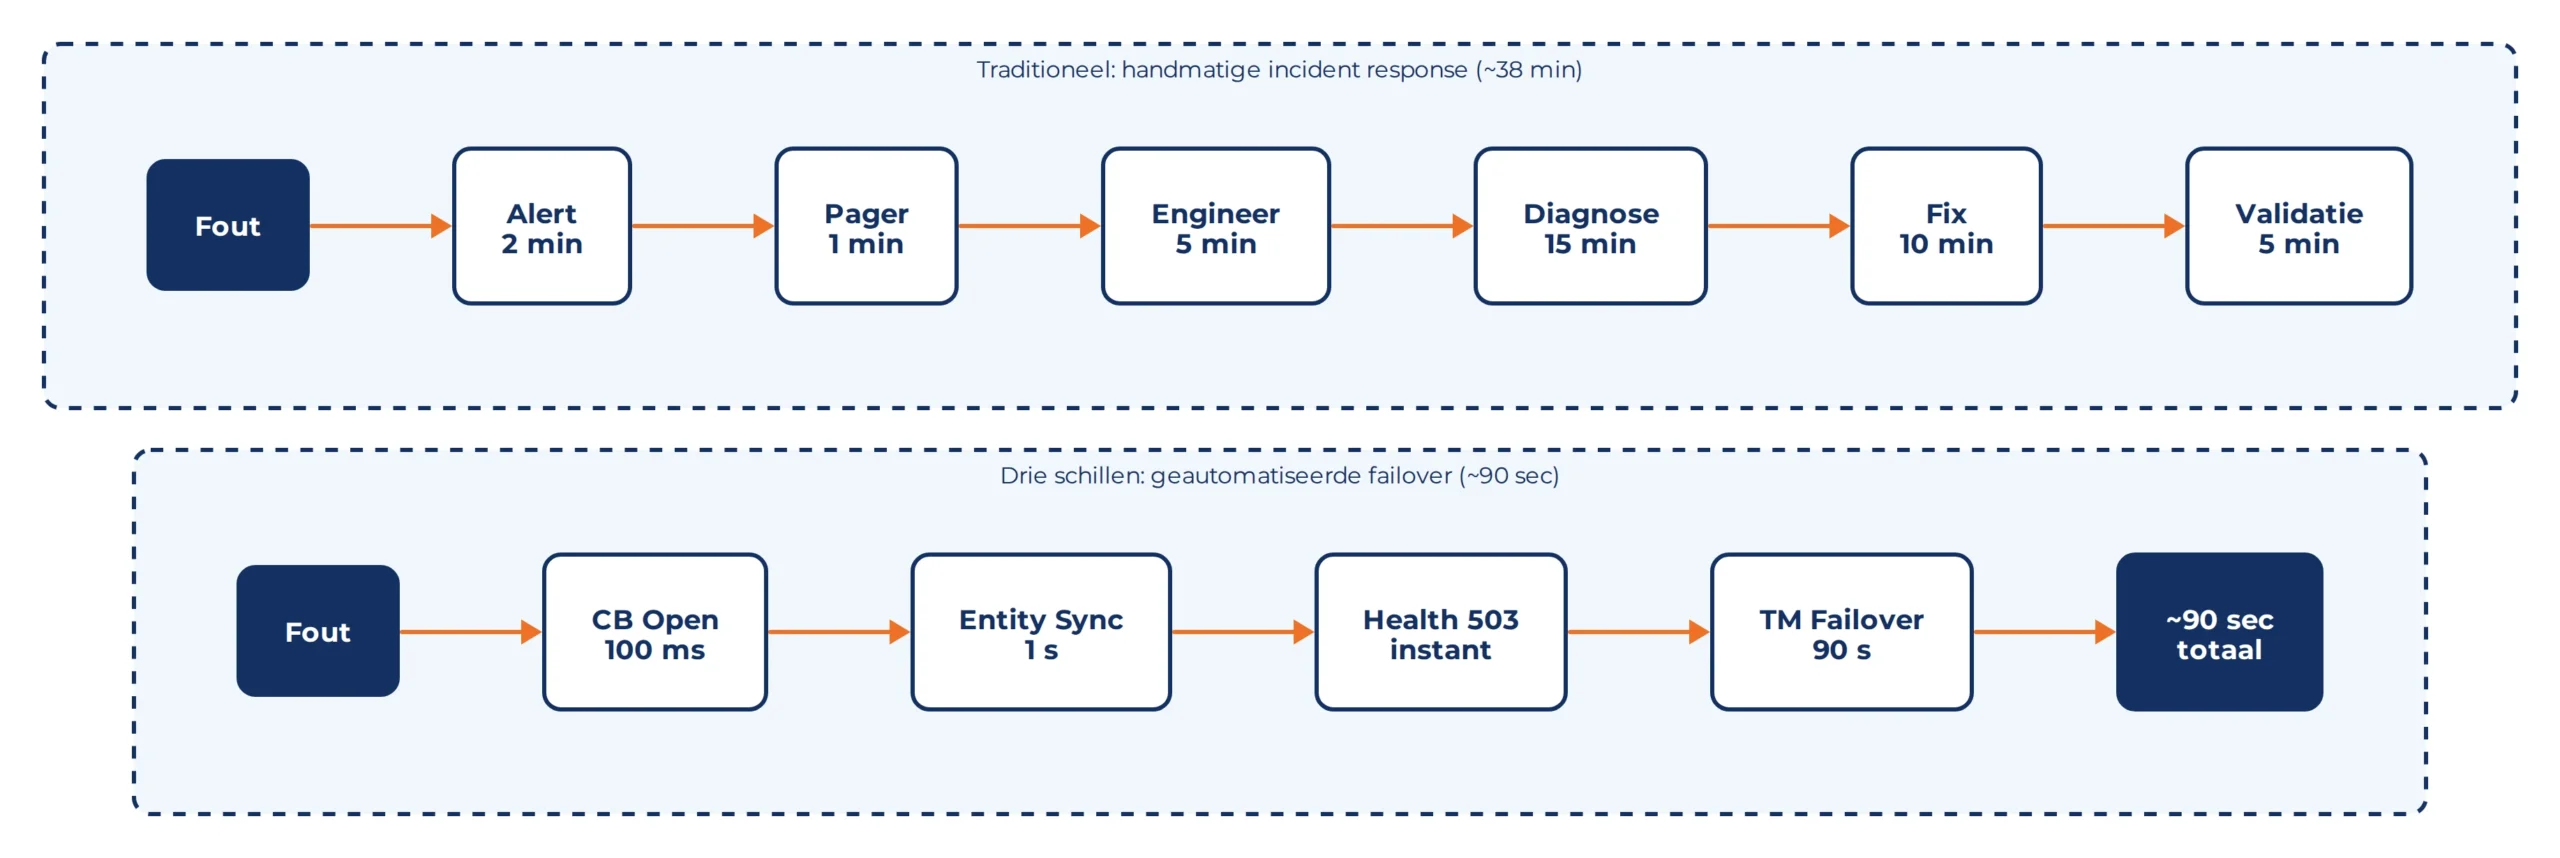
De automatisering brengt de hersteltijd (MTTR) terug van gemiddeld 38 minuten (handmatige diagnose en fix) naar circa 90 seconden (automatische failover: ~30 seconden detectie + ~60 seconden DNS-propagatie). Dit is een verbetering van ruim 25x.
De onderstaande tabel toont de impact op uptime:
| Metric | Traditioneel proces | Geautomatiseerde resilience |
|---|---|---|
| Jaarlijkse downtime (99,9%) | 8 uur 46 min | – |
| Jaarlijkse downtime (99,99%) | – | 52 min 36 sec |
| Automatische failover | Handmatig | < 2 minuten |
| Cascade-failure protectie | Geen | Per dependency |
| Cross-regio redundantie | Actief/passief | Actief/actief |
Het verschil in MTTR is aanzienlijk. De onderstaande figuur toont beide scenario’s naast elkaar.
Operationele kosten
De infrastructuurkosten voor deze oplossing zijn volgens deze inrichting minder dan €10 per regio per maand. Voor die kosten wordt een beschikbaarheid behaald die de risico’s van hoogfrequente releases helpt afdekken.
Automatische resilience
Het doel is dat het systeem automatisch detecteert en escaleert zonder handmatige interventie. Wanneer een downstream service faalt, detecteren de drie schillen dit, stoppen ze het routeren van gebruikersverkeer naar de falende regio en bewaren ze de regionale state persistent, zonder dat het operatieteam voor de initiële failover hoeft in te grijpen.
Zodra de downstream service is hersteld, reset een operator de failure-teller via Azure Table Storage, waarna Traffic Manager het verkeer automatisch hervat. De detectie en diversion zijn volledig geautomatiseerd; het herstelmoment vereist een bewuste operatorhandeling als bevestiging dat de service stabiel is.
Trunk-Based Development en resilience
De drie schillen adresseren het risico dat een hogere deploymentfrequentie met zich meebrengt, zonder de snelheid te verlagen:
- Lokaal registreert de failure-teller de impact van een defecte deployment en signaleert dit direct via het monitor-endpoint.
- Regionaal zorgt ervoor dat alle instanties in een regio synchroon reageren, ook wanneer het aantal instanties sterk toeneemt.
- Globaal leidt gebruikers om naar een regio die nog de vorige, werkende versie draait.
In een multi-regio setup met gefaseerde deployments (eerst East US, dan West Europe, dan Southeast Asia) functioneert dit als een automatisch failover-mechanisme. Wanneer een nieuwe release fouten bevat in de eerste regio, worden gebruikers omgeleid naar regio’s met de stabiele versie. Een handmatige rollback is hierdoor niet nodig.
Volgende stap
De volgende stap is het automatiseren van de laatste handmatige schakel: de operator-reset na herstel van de downstream service. Door een tijdgebaseerde HALF-OPEN-fase toe te voegen, kan het systeem zelf een beperkt aantal proberequests uitvoeren zodra de afkoelperiode is verstreken, zonder dat een operator hoeft in te grijpen. Dit brengt de MTTR nog dichter bij de theoretische ondergrens van de Traffic Manager-laag.
Benieuwd naar de implementatiedetails? Die staan uitgewerkt in het technische vervolgartikel over deze architectuur.
Voor het MIXIT-team betekent dit dat Trunk-Based Development zijn snelheid kan houden: de drie schillen vangen een deel van de degradatie op die geautomatiseerde tests niet altijd detecteren, tegen kosten van een paar euro per regio per maand.
Benieuwd hoe zo’n gelaagde resilience-architectuur in jouw cloud-landschap past? Neem contact met ons op om te bespreken hoe je deploymentsnelheid en betrouwbaarheid kunt combineren.